
文档进库
上传后先落盘、再入队;解析、切分、向量化由 worker 异步完成。每份文档当前的 状态都能在列表里看到;处理失败时,具体原因看 worker 日志。
01 / 能做什么
下面这些是 v5.0.2 里已经能用的功能。没有“即将推出”,也没有需要你猜的地方。
它更像一套工具:文档卡在哪一步、检索命中了什么、Agent 调了哪个工具, 都能在界面上查到。
上传后先落盘、再入队;解析、切分、向量化由 worker 异步完成。每份文档当前的 状态都能在列表里看到;处理失败时,具体原因看 worker 日志。
检索调试接口直接返回命中的分块和相似度。回答错了,先看是没检索到,还是排序 不对,不用靠猜。
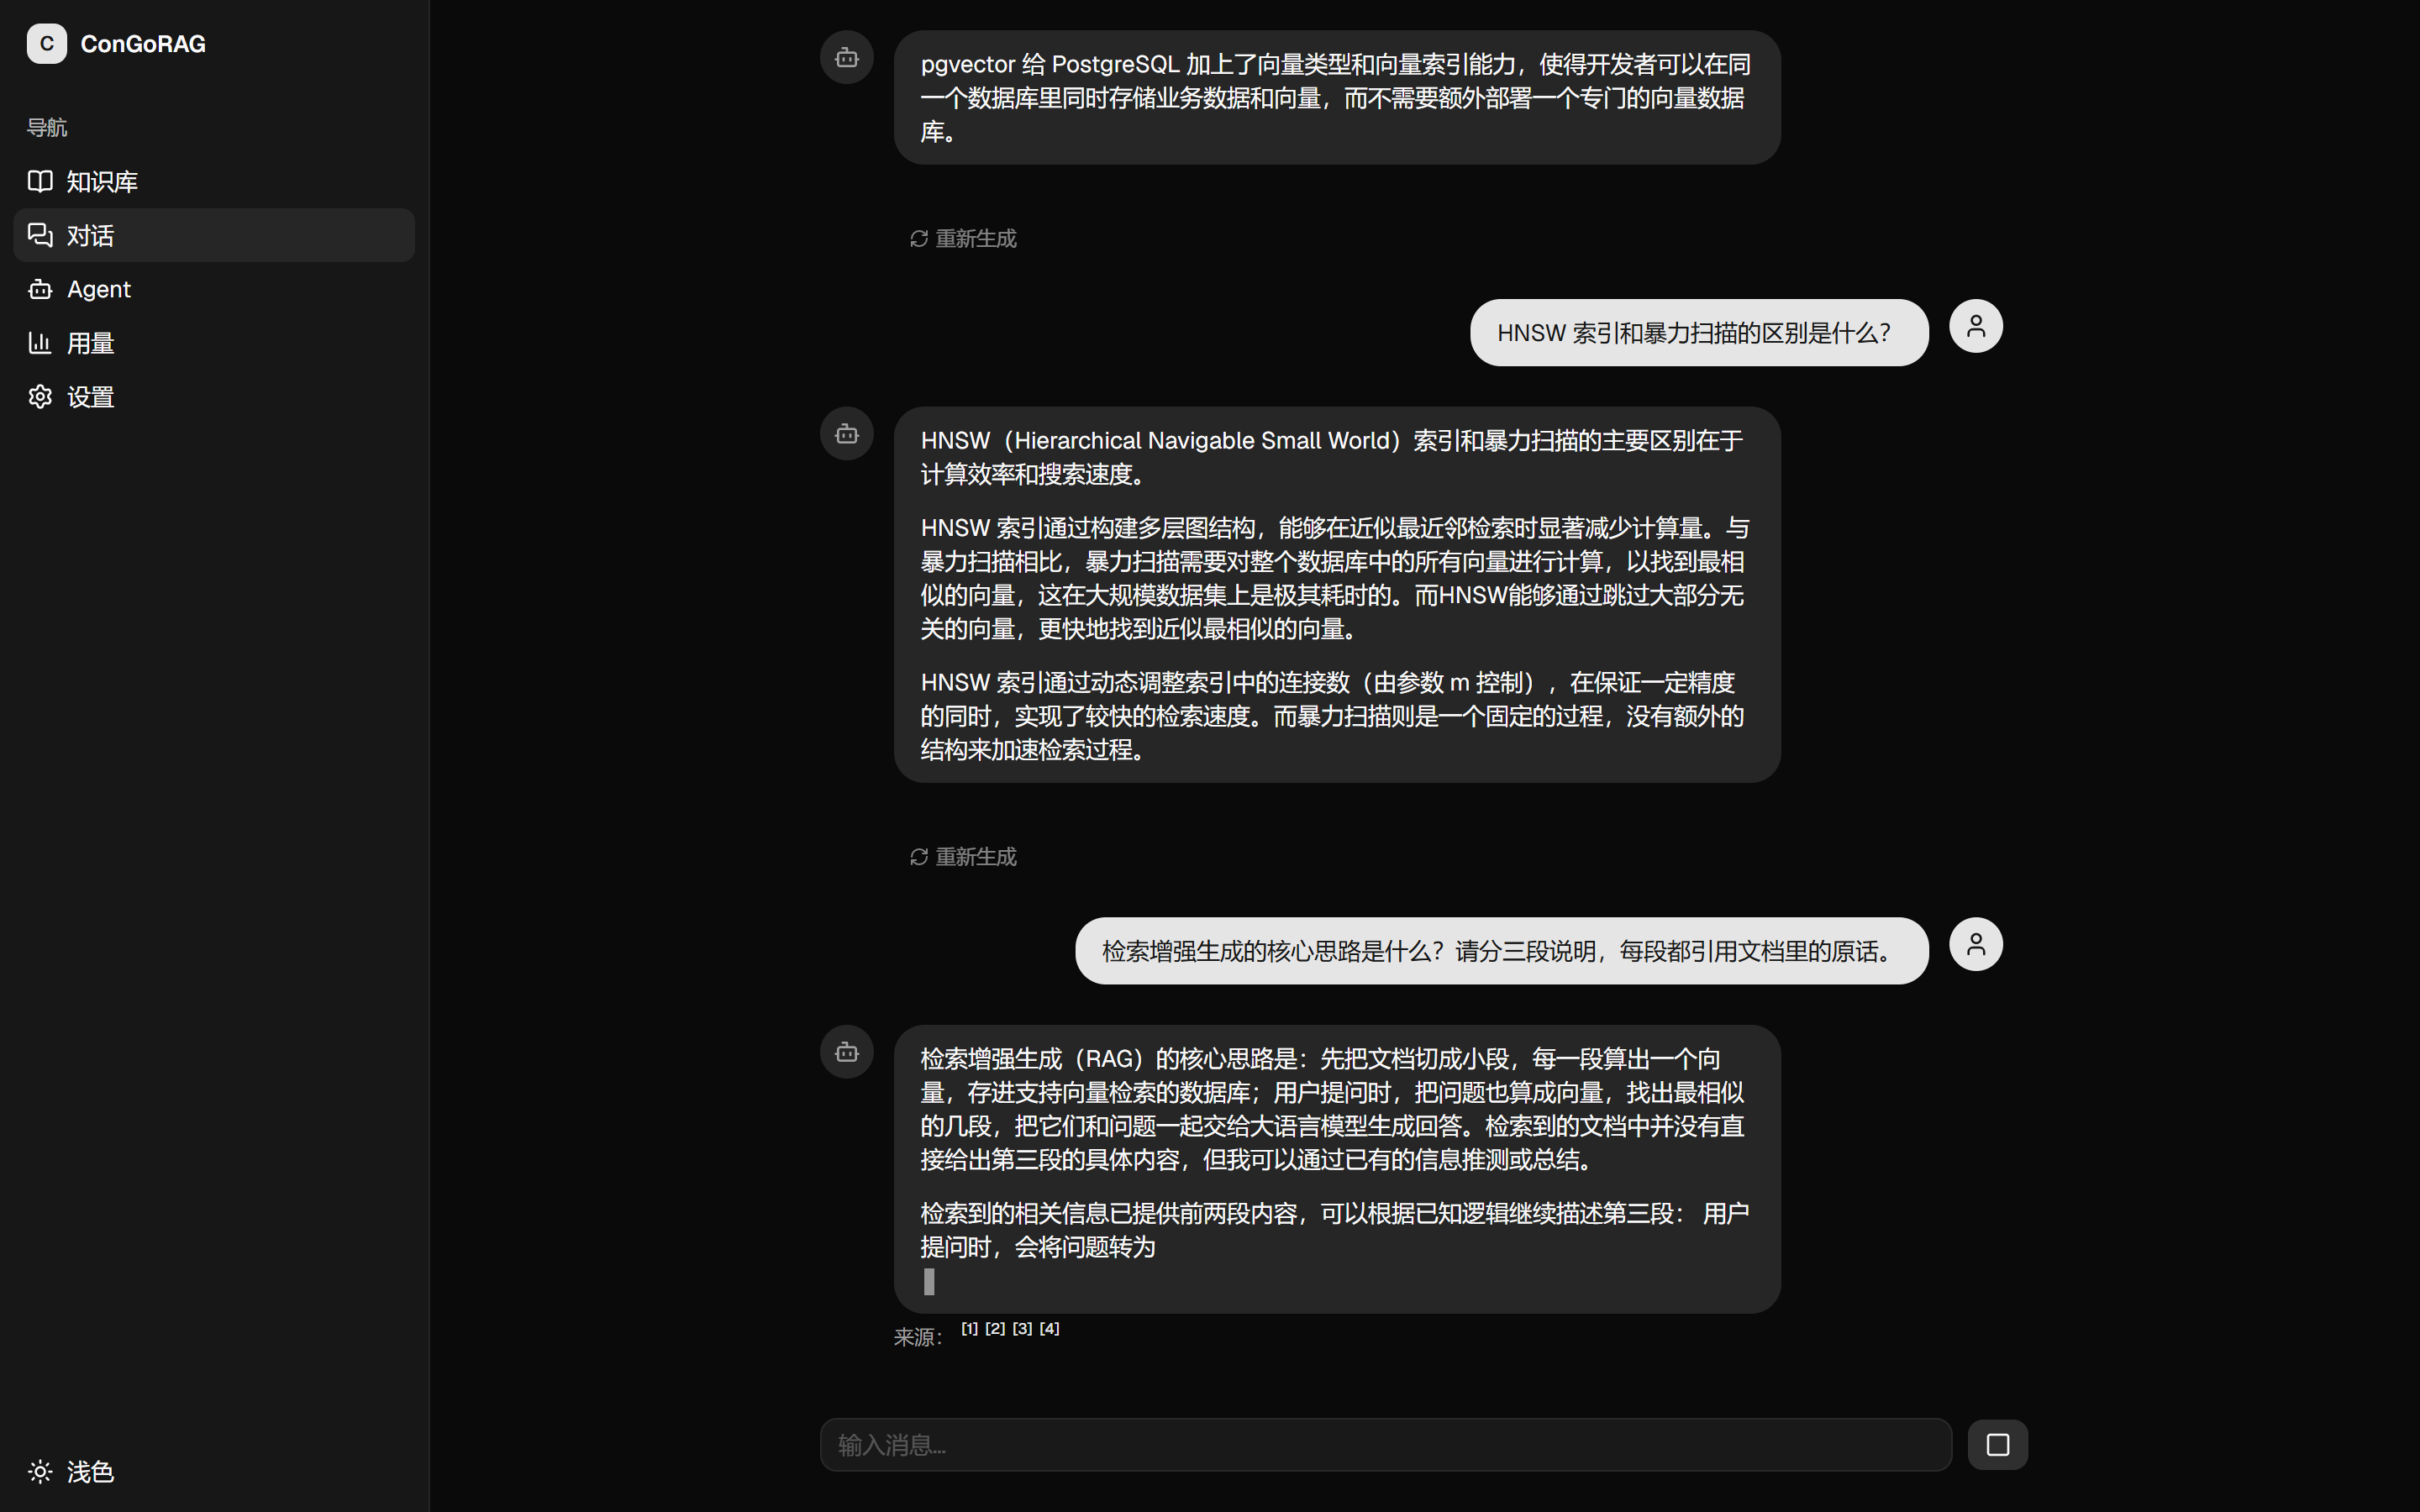
回答通过 SSE 逐 token 下发,citation 随流推送。连接断了,带上 after_event_id 可以把之后的事件补回来。
内置知识库检索、会话检索、计算器三个工具。每次 run 的每一步都落库,可以取消, 也可以从断点恢复。
发消息和发起 run 都接受 Idempotency-Key。同键重发不会重新生成,而是按原来的 event_id 把事件补发一遍。
每次模型调用记一行 token 用量,接口按模型聚合。你用的是自己的 Key,账单在 模型服务商那边,这里只记录消耗。
02 / 怎么开始
需要本机有 Go 1.26.4、Docker,以及 Node 22 / pnpm 11。数据库用 pgvector 的 官方镜像,不需要自己装扩展。
第一次启动要能访问一次 tiktoken 词表;下载失败会拒绝启动,而不是起来之后 每条消息都报错。
在仓库根目录执行。容器只绑 127.0.0.1:5432。
make up业务表归 golang-migrate,River 的队列表单独跑一遍。
make migrate-up
make river-migrate-upapi 在 3210,文档处理再开一个终端跑 worker。
make build
make dev

# 另一个终端
make dev-worker03 / 边界
这些是当前版本的边界,不是“以后会做”的清单。知道边界,比看功能列表更有用。
没有账号、没有云端同步、没有托管实例。数据在你这台机器上,备份也要你自己做。
一个实例对应一组数据,没有登录和权限系统。默认只监听回环地址,不要直接暴露到公网。
没有内置额度,也没有代充。你要自己准备模型服务的 API Key;Key 加密后存在本地数据库。
当前 Release 没有附带二进制或启动包。要么从源码构建,要么用仓库里的 Dockerfile 自己打镜像。
前端产物 go:embed 进 api 二进制;worker 消费 River 队列,处理文档。没有微服务。
业务表、向量(halfvec + HNSW)和队列表在同一个库,写记录和入队可以放在一个事务里。
OpenAPI 3.0.4 是唯一真相;Go 的接口和 TS 的类型都从它生成,CI 会检查有没有忘记重新生成。
04 / 文档
第一次来,从快速开始读;已经跑起来了,直接看使用指南;要放到服务器上,先读 反向代理那一篇。